Negli ultimi anni l’intelligenza artificiale è entrata rapidamente nella vita di tutti i giorni. La utilizziamo per scrivere un testo, riassumere un documento, creare un’immagine, tradurre una lingua, analizzare dei dati o semplicemente trovare una risposta a una domanda.
Dal punto di vista dell’utente, il funzionamento sembra quasi immediato: scriviamo una richiesta, attendiamo pochi secondi e riceviamo una risposta spesso ben costruita e apparentemente ragionata.
Ma che cosa accade realmente dietro quella schermata? Dove viene elaborata la richiesta? Che tipo di computer vengono utilizzati? E soprattutto: un’intelligenza artificiale ragiona davvero come una persona?
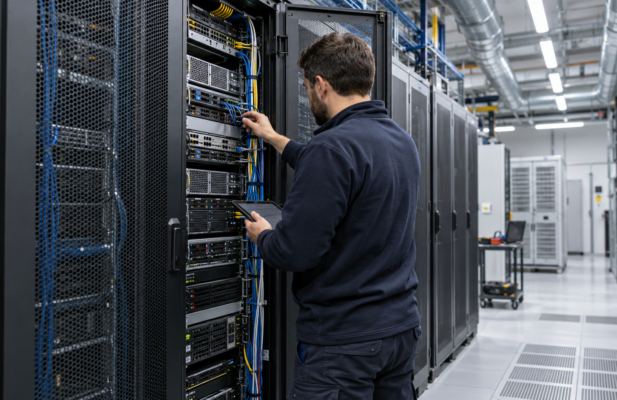
Per comprenderlo dobbiamo partire da un concetto fondamentale: l’intelligenza artificiale non vive dentro il nostro computer o il nostro telefono. Nella maggior parte dei casi, il dispositivo che utilizziamo serve soltanto per inviare la richiesta e visualizzare il risultato. Il lavoro più pesante viene svolto a distanza, all’interno di grandi centri di elaborazione chiamati data center.
Dietro una domanda apparentemente semplice
Quando scriviamo una domanda a un sistema di intelligenza artificiale e premiamo Invio, il testo viaggia attraverso Internet e raggiunge i server dell’azienda che gestisce il servizio.
A quel punto la richiesta viene presa in carico dall’infrastruttura disponibile. Non sempre esiste un singolo computer che svolge tutto il lavoro: dietro i servizi più grandi troviamo moltissime macchine collegate tra loro, organizzate per distribuire le richieste e utilizzare le risorse nel modo più efficiente possibile.
Un sistema iniziale si occupa di ricevere la comunicazione, verificare che il servizio sia disponibile e indirizzare la richiesta verso le risorse più adatte. Se un server è già molto impegnato, il lavoro può essere assegnato a un altro. Questo meccanismo permette di gestire contemporaneamente milioni di persone senza affidare tutto a una sola macchina.
Naturalmente anche queste infrastrutture hanno dei limiti. Nei momenti di maggiore utilizzo si possono verificare rallentamenti, code, interruzioni temporanee o tempi di risposta più lunghi. La sensazione, per noi, è quella di parlare con un’unica intelligenza, ma dietro le quinte lavora un sistema molto più complesso e distribuito.
Che tipo di hardware viene utilizzato?
I server dedicati all’intelligenza artificiale non sono normali computer da ufficio, anche se alcuni componenti di base sono concettualmente simili.
Troviamo processori, memoria RAM, dischi, schede di rete e alimentatori, ma con caratteristiche e prestazioni molto superiori rispetto a quelle di un comune PC.
Il processore centrale, cioè la CPU, continua ad avere un ruolo importante. Gestisce il sistema operativo, coordina le operazioni, prepara i dati e si occupa di numerosi compiti generali. Tuttavia, gran parte dei calcoli necessari per far funzionare i modelli di intelligenza artificiale viene affidata soprattutto alle GPU, processori nati originariamente per elaborare la grafica.
Le GPU sono particolarmente adatte perché possono eseguire contemporaneamente un’enorme quantità di calcoli relativamente semplici. L’intelligenza artificiale richiede proprio questo: miliardi di operazioni matematiche eseguite in parallelo e ad altissima velocità.
Esistono inoltre acceleratori progettati appositamente per l’intelligenza artificiale, capaci di svolgere determinate operazioni in maniera ancora più efficiente. Si tratta di componenti estremamente potenti e costosi, molto diversi dalle normali schede video installate nei computer domestici.
Anche la memoria è fondamentale. I modelli più grandi contengono miliardi di parametri e, per poterli utilizzare rapidamente, una parte consistente deve essere caricata nella memoria ad alta velocità collegata agli acceleratori. In questo ambito non conta soltanto la quantità disponibile, ma anche la velocità con cui i dati possono essere trasferiti.
Quando un modello non entra nella memoria di un singolo dispositivo, viene suddiviso tra più GPU o più server. Le varie macchine devono quindi comunicare continuamente tra loro attraverso collegamenti di rete velocissimi e con una latenza estremamente bassa.
È un po’ come dividere un lavoro enorme tra molte persone: il risultato può arrivare rapidamente solo se tutti riescono a scambiarsi le informazioni senza perdere tempo.
Archiviazione, memoria e reti ad altissima velocità
Nei data center vengono utilizzati sistemi di archiviazione molto performanti, spesso basati su unità SSD professionali e infrastrutture distribuite. Questi sistemi devono contenere grandi quantità di dati, copie dei modelli, configurazioni, registri tecnici e tutto ciò che serve per garantire il funzionamento del servizio.
La RAM dei server viene invece utilizzata per mantenere rapidamente disponibili le informazioni necessarie alle operazioni in corso. A questa si aggiunge la memoria specifica delle GPU, ancora più importante durante l’elaborazione del modello.
Tutti i componenti devono comunicare tra loro rapidamente. Per questo le reti interne dei data center raggiungono velocità molto superiori rispetto a quelle delle normali reti domestiche o aziendali.
A casa possiamo avere una connessione da uno o più gigabit al secondo. Nei grandi sistemi di calcolo, invece, i collegamenti tra i server possono raggiungere centinaia di gigabit al secondo e oltre, perché anche un piccolo rallentamento nella comunicazione, moltiplicato per migliaia di operazioni, può ridurre notevolmente le prestazioni dell’intero sistema.
Come viene addestrata un’intelligenza artificiale?
Prima di poter rispondere alle nostre domande, un modello deve essere addestrato.
Durante questa fase viene analizzata una quantità enorme di testi, esempi e altri contenuti, secondo il tipo di intelligenza artificiale che si vuole realizzare. Il sistema non conserva semplicemente tutto come se fosse un archivio tradizionale, ma modifica progressivamente miliardi di valori numerici interni, chiamati parametri.
Questi parametri rappresentano le relazioni apprese tra parole, concetti, strutture linguistiche e informazioni.
L’addestramento richiede una potenza di calcolo enorme e può coinvolgere contemporaneamente moltissime GPU per periodi prolungati. Durante il processo il sistema prova a prevedere un risultato, confronta la previsione con quello corretto e modifica leggermente i propri parametri. Ripetendo questa operazione un numero impressionante di volte, diventa progressivamente più capace di riconoscere schemi e produrre risposte coerenti.
Una volta completato l’addestramento principale, il modello può essere ulteriormente perfezionato attraverso esempi selezionati, valutazioni umane, procedure automatiche e regole di sicurezza.
L’addestramento, quindi, è la fase nella quale il sistema “impara”. Quando invece gli facciamo una domanda e genera una risposta, ci troviamo nella fase chiamata inferenza, cioè nell’utilizzo pratico di ciò che è stato precedentemente appreso.
L’intelligenza artificiale ragiona davvero?
È probabilmente la domanda più interessante.
Quando leggiamo una risposta articolata, potremmo avere l’impressione che dall’altra parte ci sia qualcuno che abbia compreso pienamente la nostra richiesta, l’abbia valutata e abbia formulato una propria opinione.
In realtà il funzionamento è differente da quello del cervello umano.
Il testo viene suddiviso in piccole unità chiamate token, che possono corrispondere a parole, parti di parole, numeri o segni di punteggiatura. Il modello analizza la richiesta, le relazioni tra questi elementi e il contesto della conversazione, quindi calcola quale token abbia maggiore probabilità di essere adatto come continuazione.
La risposta viene generata progressivamente, un elemento dopo l’altro.
Questo non significa che il sistema scelga banalmente la parola più frequente. I modelli moderni riescono a rappresentare relazioni molto complesse e possono seguire istruzioni, confrontare informazioni, applicare procedimenti logici e costruire spiegazioni articolate.
Tuttavia, il loro “ragionamento” non coincide con quello umano. Un’intelligenza artificiale non possiede necessariamente coscienza, esperienza personale, emozioni o comprensione del mondo nello stesso senso in cui le intendiamo noi.
Produce un risultato sulla base dei modelli appresi e del contesto ricevuto. Proprio perché il risultato viene generato attraverso calcoli probabilistici, può anche costruire una risposta molto convincente ma sbagliata.
Perché a volte l’intelligenza artificiale inventa?
Quando un sistema fornisce informazioni inesatte o addirittura inesistenti, si parla spesso di “allucinazione”.
L’intelligenza artificiale non sta necessariamente mentendo nel significato umano del termine. Sta generando una continuazione che, secondo i suoi calcoli, appare coerente con la richiesta. Se però non dispone di informazioni sufficienti, se la domanda è ambigua o se cerca di completare un dettaglio molto specifico, può produrre qualcosa di plausibile ma non vero.
È uno dei motivi per cui l’intelligenza artificiale deve essere utilizzata come uno strumento di supporto e non come una fonte infallibile.
Per argomenti importanti, dati precisi, normative, diagnosi, sicurezza informatica o decisioni economiche, le informazioni devono sempre essere controllate. La qualità della risposta dipende anche da come viene formulata la domanda, dal contesto fornito e dagli strumenti ai quali il sistema può accedere.
L’intelligenza artificiale è sempre collegata a Internet?
Non necessariamente.
Un modello può avere una conoscenza derivata dal proprio addestramento senza essere collegato in quel momento al Web. In questo caso non “cerca” la risposta online: la genera utilizzando ciò che ha appreso.
Alcuni servizi possono però affiancare al modello strumenti aggiuntivi, come la ricerca sul Web, l’accesso a documenti, l’esecuzione di programmi o l’interrogazione di archivi aziendali. In questi casi l’intelligenza artificiale può recuperare informazioni aggiornate e utilizzarle per costruire la risposta.
È quindi importante distinguere tra ciò che il modello conosce grazie all’addestramento e ciò che viene realmente verificato attraverso una fonte esterna.
Come fanno i server a non surriscaldarsi?
Tutta questa potenza di calcolo produce una quantità enorme di calore. Le GPU e gli acceleratori dedicati all’intelligenza artificiale consumano molta energia e, se non venissero raffreddati correttamente, raggiungerebbero rapidamente temperature incompatibili con il funzionamento.
Nei data center tradizionali il raffreddamento può avvenire attraverso grandi impianti di climatizzazione. I server vengono disposti in file organizzate in corridoi caldi e freddi: davanti alle apparecchiature arriva aria raffreddata, mentre l’aria calda espulsa posteriormente viene raccolta e allontanata senza mescolarsi con quella fredda.
Ventole ad alta capacità fanno circolare continuamente l’aria attraverso i server. Sensori distribuiti controllano temperatura, umidità, pressione e funzionamento degli impianti.
Con l’aumento della densità di potenza, però, il solo raffreddamento ad aria può non essere sufficiente. Per questo nei sistemi più moderni viene utilizzato sempre più spesso il raffreddamento a liquido.
Il liquido può essere portato direttamente vicino ai componenti più caldi attraverso apposite piastre, assorbendo il calore in maniera molto più efficiente dell’aria. Esistono anche soluzioni nelle quali intere apparecchiature vengono immerse in fluidi speciali non conduttivi, sebbene non siano utilizzate in tutti i data center.
Il calore raccolto deve comunque essere trasferito all’esterno attraverso scambiatori, torri di raffreddamento o altri sistemi. In alcune strutture può perfino essere recuperato e riutilizzato per riscaldare edifici o alimentare reti di teleriscaldamento.
La scelta del luogo in cui costruire un data center dipende quindi anche dalla disponibilità di energia, dalle temperature ambientali, dalle risorse idriche, dalla connettività e dalla possibilità di smaltire efficacemente il calore.
Energia, continuità e sistemi di emergenza
Un servizio utilizzato da milioni di persone non può fermarsi per un semplice guasto elettrico.
I data center dispongono normalmente di alimentazioni ridondanti, gruppi di continuità, batterie e generatori di emergenza. Anche le linee Internet, gli apparati di rete, le pompe di raffreddamento e gli altri componenti critici vengono duplicati dove necessario.
Se un alimentatore, un disco, un collegamento o un’intera macchina si guasta, l’infrastruttura deve riuscire a spostare il lavoro altrove. Lo stesso principio può essere applicato a più edifici o aree geografiche, in modo da mantenere il servizio disponibile anche in caso di problemi più estesi.
Naturalmente nessuna infrastruttura è completamente immune dai guasti, ma la ridondanza serve proprio a evitare che il malfunzionamento di un singolo componente blocchi l’intero sistema.
Che cosa determina la velocità della risposta?
Le prestazioni dipendono da diversi elementi.
Contano la dimensione del modello, il numero di utenti collegati, la quantità di hardware disponibile, la velocità delle GPU, la memoria, la rete interna, la lunghezza della richiesta e quella della risposta.
Un modello più grande può richiedere maggiori risorse, mentre uno più piccolo può essere più rapido ed economico. Per questo non tutte le richieste vengono necessariamente gestite dallo stesso tipo di modello o dalla stessa configurazione hardware.
Anche la distanza dal data center e la qualità della nostra connessione hanno un ruolo, ma spesso il tempo principale viene impiegato nell’elaborazione vera e propria.
Quando vediamo il testo comparire gradualmente sullo schermo, non è soltanto un effetto grafico: molto spesso la risposta viene realmente prodotta man mano, token dopo token, e trasmessa immediatamente al nostro dispositivo.
I dati inviati all’intelligenza artificiale
Un altro aspetto importante riguarda la riservatezza.
Quando utilizziamo un servizio online, ciò che scriviamo viene trasmesso ai server che devono elaborarlo. Il trattamento e l’eventuale conservazione dei dati dipendono dal servizio utilizzato, dal tipo di account, dalle impostazioni e dalle condizioni contrattuali.
Per questo motivo è sempre opportuno evitare di inserire password, credenziali, dati sanitari, documenti riservati, informazioni aziendali sensibili o dati personali di terzi senza avere verificato come verranno trattati.
L’intelligenza artificiale può essere uno strumento estremamente utile, ma va utilizzata con la stessa attenzione che dovremmo avere con qualsiasi altro servizio cloud.
Esistono anche intelligenze artificiali che funzionano in locale
Non tutti i modelli devono necessariamente essere eseguiti nei grandi data center.
Esistono modelli più piccoli che possono funzionare direttamente su computer, workstation, server aziendali e perfino smartphone recenti. In questo caso i dati possono rimanere all’interno del dispositivo o della rete locale, con vantaggi per la riservatezza e per l’utilizzo anche senza connessione Internet.
La qualità e la velocità dipendono però dall’hardware disponibile. Un computer dotato di una buona GPU e di molta memoria può gestire modelli più complessi, mentre un dispositivo meno potente dovrà utilizzare versioni ridotte o maggiormente ottimizzate.
Le soluzioni locali possono essere molto interessanti in determinati contesti, ma non raggiungono sempre le capacità e la comodità offerte dalle grandi infrastrutture cloud.
Una tecnologia potente, ma pur sempre uno strumento
L’intelligenza artificiale può sembrare qualcosa di astratto o quasi magico. In realtà, dietro ogni risposta esistono componenti molto concreti: server, processori, GPU, memorie, reti, sistemi di archiviazione, impianti elettrici e potenti sistemi di raffreddamento.
Sopra questa infrastruttura lavora un modello matematico addestrato su enormi quantità di dati, capace di analizzare il contesto e generare risultati con una velocità che fino a pochi anni fa sarebbe sembrata impensabile.
Ma velocità e capacità di elaborazione non significano automaticamente verità assoluta.
L’intelligenza artificiale può aiutarci a lavorare meglio, comprendere argomenti complessi, organizzare informazioni e sviluppare nuove idee. Il risultato migliore si ottiene però quando alla potenza della macchina si affiancano l’esperienza, il controllo e il giudizio umano.
La vera differenza, come avviene con qualsiasi tecnologia, non la fa soltanto lo strumento: la fa il modo in cui scegliamo di utilizzarlo.